System One Models: qué son y cuándo conviene usar un modelo como Jev en vez de un LLM
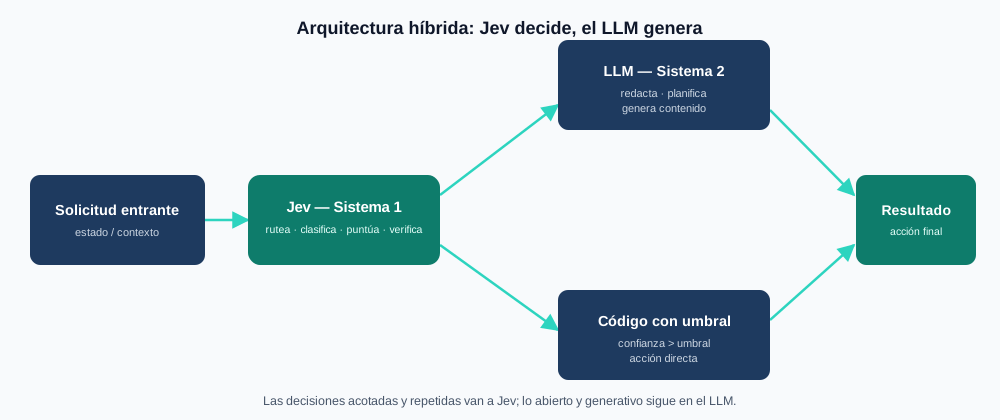
La mayoría de las decisiones que toma un agente en producción no son conversaciones. Son clasificaciones: ¿a qué cola va este ticket? ¿esta herramienta es la correcta para este paso? ¿esta respuesta del LLM está justificada por la fuente que cita? ¿este texto es un intento de jailbreak? Durante los últimos años resolvimos todas esas preguntas con el mismo martillo: un LLM generativo, autoregresivo, que primero escribe una explicación en prosa y después —con suerte— la estructura en un JSON parseable. Funciona, pero es lento, caro y no fue entrenado para eso.
En septiembre de 2026, TypeSafe AI lanzó Jev, presentado como el primer "System One Model" disponible públicamente: un modelo que no genera texto sino que evalúa un estado y devuelve decisiones tipadas con probabilidades calibradas. El nombre es una referencia directa a la distinción de Daniel Kahneman entre el Sistema 1 (rápido, intuitivo, de patrón) y el Sistema 2 (lento, deliberado, de razonamiento) del pensamiento humano. Un LLM conversacional razonando paso a paso se parece al Sistema 2. Jev está diseñado para ser el Sistema 1 de un agente: la pieza que decide rápido, sin narrar el porqué.
Qué es un System One Model
Según la documentación de TypeSafe, un System One Model está diseñado para "tomar decisiones rápidas y estructuradas que el software pueda usar directamente". En vez de generar texto libre, evalúa un estado y devuelve respuestas tipadas y probabilidades. Jev, su primer modelo público, se describe como "una función de llamada de inteligencia de frontera: entra estado no estructurado, salen decisiones probabilísticas tipadas".
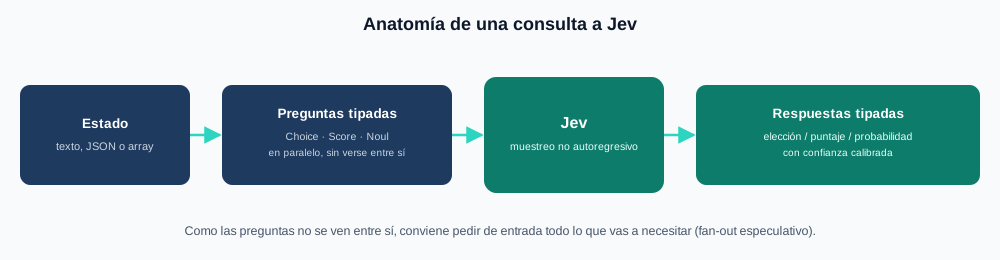
La diferencia arquitectónica central es que Jev no es autoregresivo: no genera token por token en secuencia, sino que produce todas las respuestas de una consulta en paralelo, en una sola pasada. Eso es lo que le permite responder en milisegundos en lugar de segundos, y es también la razón por la que "no puede alucinar" en el sentido estricto: como el espacio de salidas válidas está definido de antemano por un esquema, es matemáticamente imposible que devuelva un valor que no pertenezca a ese esquema.
Las preguntas que se le hacen a Jev se arman con tres primitivas:
- Choice: elegir una opción de una lista predefinida, devolviendo una probabilidad para cada opción.
- Score: ubicar el estado en una rúbrica ordenada, con una posición ponderada por probabilidad que puede caer entre dos niveles.
- Noul: devolver una única probabilidad de que un enunciado sea verdadero (un booleano probabilístico).
Todas las preguntas de una misma consulta se evalúan contra el mismo estado y pueden combinarse libremente en una sola llamada.
En qué se diferencia de un LLM tradicional
| Jev / System One | LLM estándar | |
|---|---|---|
| Optimización | RL para Decisiones Calibradas (RLCD): probabilidades epistémicamente honestas | RLHF/RLVR: preferencia humana o recompensa verificable |
| Entrada | Estado de programa estructurado | Mensajes secuenciales de conversación |
| Salida | Valores tipados con confianza calibrada | Strings libres que hay que parsear y validar |
| Muestreo | Paralelo: todas las salidas en una sola pasada | Autoregresivo: token por token |
| Riesgo de alucinación | Nulo por diseño (el esquema restringe la salida) | Presente; requiere validación downstream |
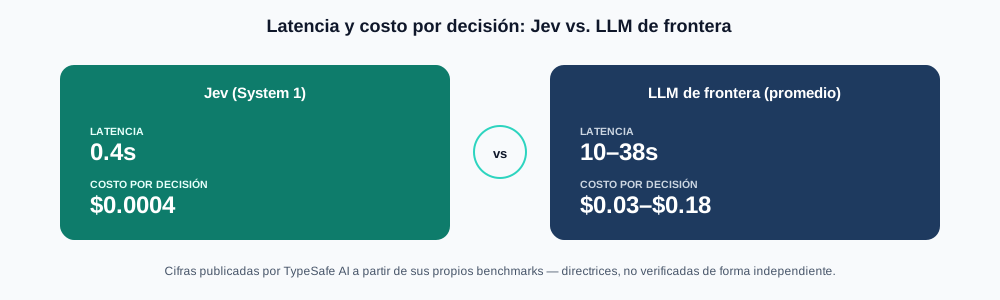
| Latencia típica | ~70–500 ms | Segundos a decenas de segundos |
| Costo | Entrada ~USD 0,042/MTok; salida gratis | Entrada USD 0,20–10/MTok; salida ~5x más cara |
La calibración merece una aclaración aparte: no es lo mismo que precisión. Un modelo calibrado es aquel en el que "80% de confianza" significa, empíricamente, que acierta el 80% de las veces que dice eso — ni más ni menos. Los LLM generales son notoriamente sobreconfiados: dicen "estoy seguro" con la misma exposición emocional en una respuesta correcta que en una inventada. TypeSafe entrena a Jev específicamente para que su confianza sea honesta, con RLCD, lo que permite que el código de la aplicación actúe directamente sobre el número sin necesidad de una capa adicional de verificación humana.
Qué tipo de decisiones puede tomar
Jev no reemplaza a un LLM generativo: reemplaza el paso de decisión que hoy, en la mayoría de los pipelines de agentes, sigue resuelto con un LLM generativo o con reglas hardcodeadas frágiles. Los casos de uso más citados son:
- Ruteo y triage: a qué cola, equipo o flujo debe ir una solicitud entrante.
- Clasificación y etiquetado: categorizar documentos, tickets o eventos contra un conjunto fijo de etiquetas.
- Validación de selección de herramientas: confirmar que la herramienta que un agente está por invocar es efectivamente la correcta para el paso actual, antes de ejecutarla.
- Scoring contra una rúbrica: puntuar leads, currículums, o registros según criterios definidos.
- Screening de seguridad: detectar intentos de jailbreak o violaciones de política en el input antes de que llegue al LLM principal.
- Verificación de salidas de LLM: el patrón híbrido más interesante. Un LLM generativo extrae un dato de un documento; Jev recibe el valor extraído junto con la fuente y responde, como un Noul tipado, si esa extracción está efectivamente respaldada por el texto.
La regla que proponen sus propios creadores para decidir cuándo usarlo es simple y las tres condiciones tienen que cumplirse a la vez: ya conocés el conjunto de respuestas posibles, tomás la misma decisión de forma repetida, y podés actuar sobre un score de confianza. Si falta cualquiera de las tres —la respuesta es abierta, es una decisión que se toma una sola vez, o necesitás una explicación en lenguaje natural del porqué— un LLM generativo sigue siendo la herramienta correcta.
Cómo lo hace: fan-out especulativo y arquitectura de producción
Una característica poco intuitiva pero central del diseño de Jev es que las preguntas dentro de una misma consulta no pueden verse entre sí. Esto no es una limitación menor: es lo que habilita el patrón de fan-out especulativo, es decir, preguntar de entrada todo lo que eventualmente vas a necesitar saber, en una sola llamada paralela, en vez de encadenar llamadas secuenciales donde cada una depende de la anterior. TypeSafe reporta que agrupar diez preguntas en una sola consulta es significativamente más eficiente que diez llamadas secuenciales —hasta 5,9 veces menos tokens en sus propios ejemplos— precisamente porque el modelo no tiene que regenerar contexto compartido en cada llamada.
Un ejemplo conceptual de cómo se ve esto en código (simplificado, no es la sintaxis exacta del SDK):
from typesafe import Client, Choice, Score, Noul

client = Client(api_key=API_KEY)

result = client.evaluate(
    state=support_ticket_text,
    questions={
        "queue": Choice(options=["billing", "technical", "abuse", "sales"]),
        "urgency": Score(rubric="1 (bajo) a 5 (crítico)"),
        "is_duplicate": Noul(statement="Este ticket repite un reclamo ya abierto"),
    },
)

THRESHOLDS = {"is_duplicate": 0.85}  # el umbral vive en el código, no en el prompt

if result.is_duplicate.probability > THRESHOLDS["is_duplicate"]:
    merge_with_existing_ticket()
else:
    route_to_queue(result.queue.choice)
Algunas prácticas de producción que se repiten en la documentación y en las guías técnicas publicadas sobre Jev:
- Los pesos y umbrales de decisión viven en el código de la aplicación, no en el prompt. Esto los hace revisables, testeables y versionables como cualquier otra lógica de negocio.
- El scoring compuesto se arma con preguntas atómicas. En vez de pedirle al modelo una evaluación multifactor en una sola pregunta ("¿es un buen candidato?"), se descompone en dimensiones separadas (experiencia, comunicación, ajuste cultural) y la ponderación se aplica después, en código — lo que permite re-rankear sin volver a inferir.
- Jev no cuenta de forma confiable dentro de una sola pregunta. Si necesitás contar elementos, la recomendación es pedir un Noul por ítem y sumarlos en código, en vez de pedirle al modelo que cuente directamente.
- El estado que le pasás define exactamente lo que el modelo puede saber. Cuando el contexto tiene varias partes relevantes, conviene pasarlo como campos nombrados en vez de texto plano concatenado.
- Los juicios del modelo se guardan separados de la política de decisión. Esto permite cambiar un umbral o una ponderación y volver a evaluar sin pagar una nueva inferencia.
- En producción, las llamadas van con reintentos acotados, backoff y timeouts por llamada, y en arquitecturas async se paralelizan las decisiones independientes en vez de encadenarlas.
Las salvedades que conviene tener presentes
Ningún artículo sobre un producto que se lanzó hace pocas semanas debería presentarse sin sus límites. Los benchmarks publicados por TypeSafe muestran una precisión de 67,8% en sus cuatro flujos de evaluación, comparable a GPT-5.6 Terra (67,9%) pero por debajo de GPT-5.6 Sol (74,1%) y Claude Opus 5 (73,1%). La ganancia real de Jev no es precisión bruta: es velocidad y costo por decisión, del orden de decenas a cientos de veces menor, en decisiones que ya sabés cómo estructurar.
Además: los flujos de evaluación fueron diseñados por el propio equipo de TypeSafe, sin reproducción independiente todavía disponible; la compañía misma reconoce que no puede probar que sus precios no estén subsidiados; y —la limitación más relevante para dominios regulados— Jev no da una explicación en lenguaje natural de por qué llegó a un número. Eso importa para debugging y para auditoría en sectores donde una decisión automatizada necesita justificarse ante un humano. Por ahora, además, solo acepta texto como entrada: nada de imágenes ni de otras modalidades.
Ninguna de estas salvedades invalida la idea central. Solo confirman que, como cualquier herramienta nueva y especializada, conviene adoptarla donde su forma encaja —decisiones acotadas, repetidas, accionables sobre un score— y no como reemplazo universal del LLM generativo que sigue siendo, por ahora, la pieza correcta para todo lo que no entra en ese molde.
Sources: